Research.

Speech separation, neural audio codecs, and robust speech recognition.

Overview

Speech separation with neural audio codecs

I study how the layered representations of neural audio codecs can help separate overlapping voices. My work focuses on preserving the coarse-to-fine structure of residual vector quantization (RVQ) layers.

Conceptual view of codec-based speech separation.

Publications

2026

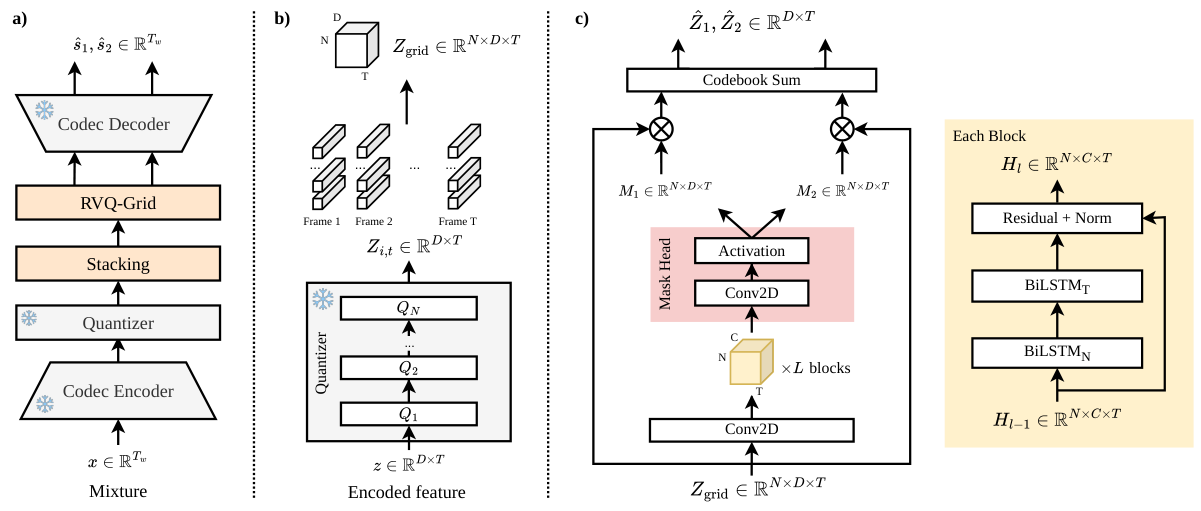
RVQ-Grid architecture: frozen codec pipeline, stacked RVQ vectors and dual-axis recurrent separator (Figure 1).

Improving Audio Codec-based Speech Separation By Stacking Residual Vector Quantization Layers

Nhu Minh Phuong Dinh, Roland Hartanto, Koichi Shinoda

Interspeech 2026 · pp. 7153–7157

RVQ-Grid explores the structure of residual vector quantization layers for speech separation in neural audio codec representations.

inputmodeloutput

Cross-layer recurrent processing of Residual Vector Quantization layers for Audio Codec-based speech separation

Nhu Minh Phuong Dinh, Roland Hartanto, Koichi Shinoda

IEICE Technical Report · SP2026-23 · pp. 125–129

Cross-layer recurrent processing preserves the coarse-to-fine structure of RVQ layers for codec-based speech separation.
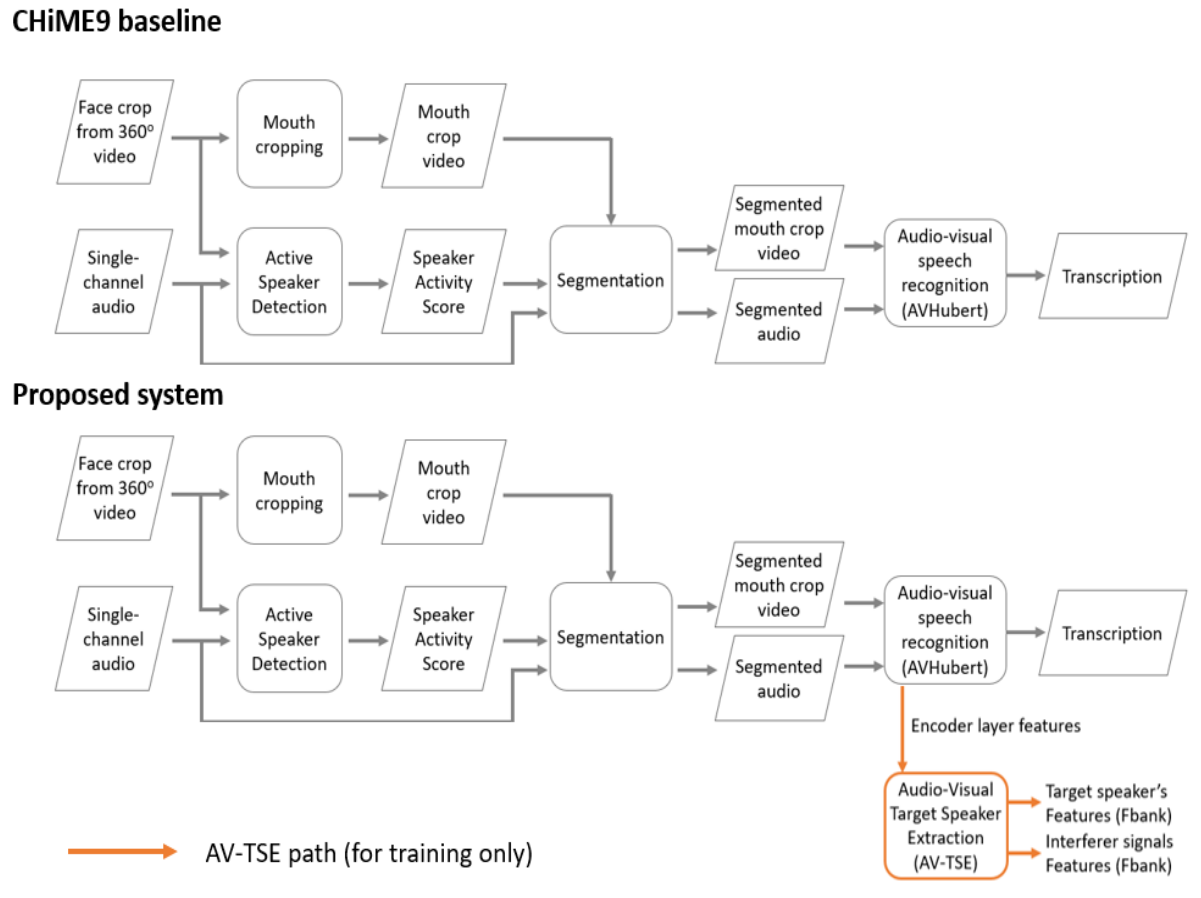
CHiME-9 MCoRec architecture: baseline and proposed audio-visual ASR system with an auxiliary target-speaker extraction training path (Figure 1).

Science Tokyo CHiME-9 MCoRec System Description

Roland Hartanto, Daichi Nitsu, Nhu Minh Phuong Dinh, Koichi Shinoda

CHiME 2026 · pp. 21–25

Joint training combines audio-visual speech recognition and target speaker extraction to handle overlapping conversations.